
Entwertet das Klonen von Software per KI-Agent das Software-Copyright?
KI-Agenten können bestehende Softwarekomponenten anhand von Spezifikationen oder Schnittstellenbeschreibungen autonom neu implementieren. Da dabei kein fremder Quellcode in das eigene System kopiert wird, greift das klassische Clean-Room-Verfahren inzwischen bei alltäglichen Modulen. Das stellt den praktischen Schutzwert traditioneller Software-Lizenzen und Urheberrechte grundsätzlich infrage.
Leistungsfähige KI-Agenten verändern die Umsetzung von Softwareprojekten und verschieben die Grenzen des Urheberrechts. Wenn Entwickler Quellcode nicht mehr von Hand schreiben, sondern Systeme ihn anhand bestehender Komponenten reproduzieren lassen, greifen herkömmliche Schutzmechanismen nicht mehr wie vorgesehen. Im Kern geht es um die Frage, wie belastbar das Software-Copyright gegenüber einer automatisierten Rekonstruktion noch ist.
Konflikte bei der Wiederverwendung fremden Codes
In der Softwareentwicklung gehört der Rückgriff auf bestehende Bibliotheken zum Standard. Entwickler kommerzieller Closed-Source-Produkte stoßen dabei regelmäßig auf Komponenten, die eine Aufgabe exakt lösen, deren Lizenz aber einer Integration im proprietären Kontext im Weg steht. Ursache sind meist restriktive Vorgaben wie strikte Copyleft-Bedingungen oder Klauseln, die kommerzielle Nutzung ausdrücklich ausschließen.
Bislang verlangte ein solcher Lizenzkonflikt eine von drei Reaktionen:
Den Zukauf einer passenden kommerziellen Lizenz beim Rechteinhaber, sofern dieser eine anbietet.
Die Suche nach einer alternativen Bibliothek unter kompatibler Lizenz, oft verbunden mit funktionalen Abstrichen.
Die vollständige Eigenimplementierung der Logik von Hand mit entsprechendem Zeit- und Kostenaufwand.
Mit KI-Agenten öffnet sich ein alternativer Weg: die automatisierte Rekonstruktion der Zielkomponente über Prompts an generative Modelle. Dieser Ansatz wirft die Frage auf, an welcher Stelle im Prozess Rechtsverletzungen entstehen, ob der Nachbau bestehende Lizenzverträge bricht und wie weit der Urheberrechtsschutz bei maschineller Neugenerierung überhaupt trägt.
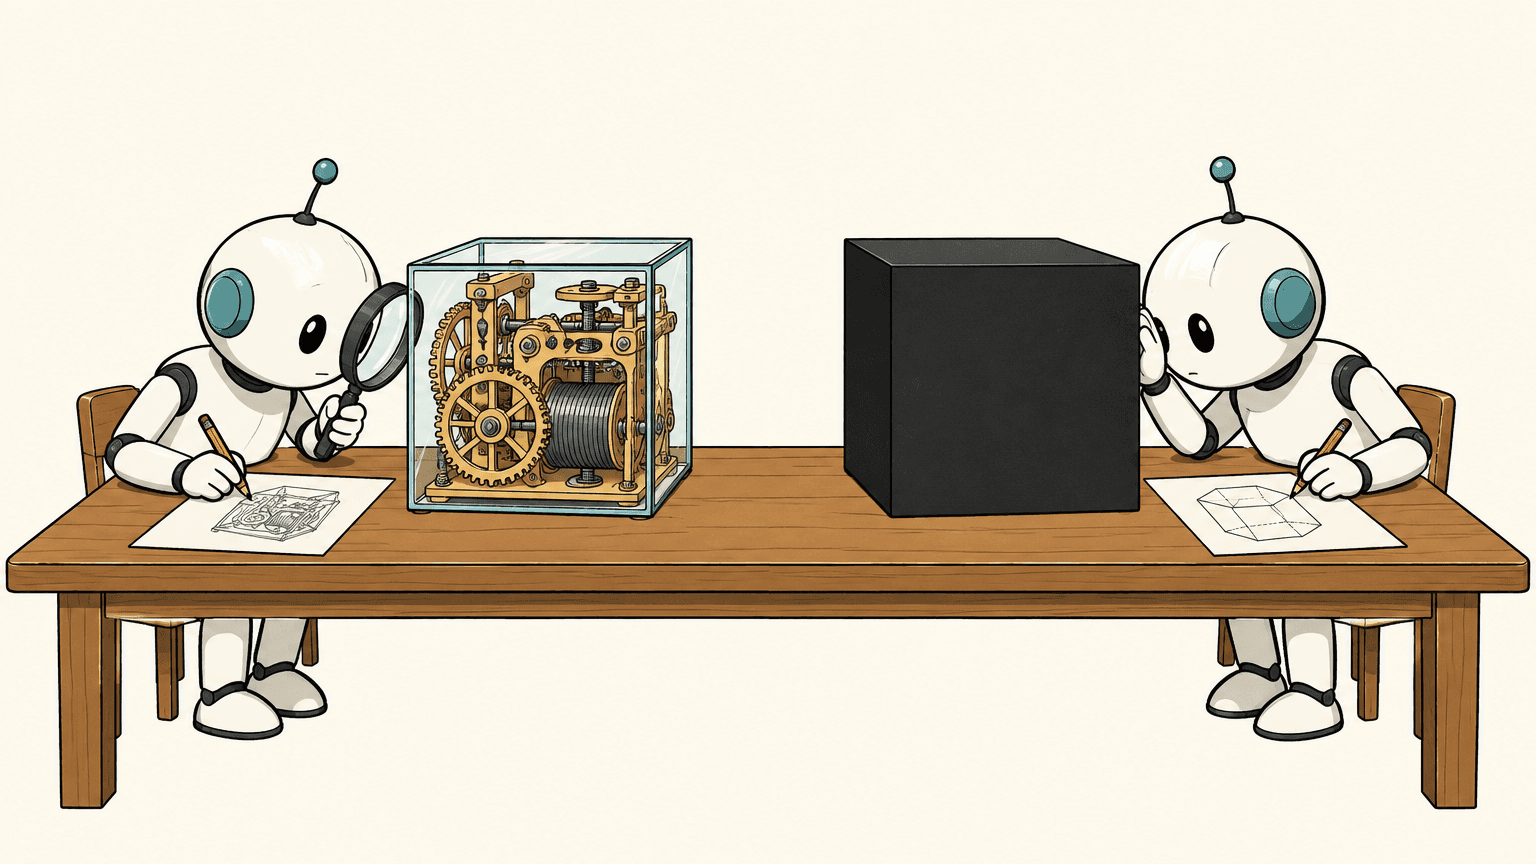
White box cloning versus black box cloning - Zwei Wege des KI-gestützten Re-Engineerings
Die Rekonstruktion von Softwarefunktionen durch generative Modelle folgt technisch zwei unterschiedlichen Mustern. Ausschlaggebend ist, ob der ursprüngliche Quelltext als Eingabe dient oder ob das System das beobachtbare Verhalten von außen nachbildet.
Quelltextbasierte Neugenerierung im Whitebox-Verfahren
Beim Whitebox-Cloning liegt der Quellcode der Vorlage vor. Das betrifft vor allem Software, deren Code zwar öffentlich einsehbar ist, deren Lizenz eine Weiterverwendung in proprietären Systemen jedoch verbietet. Der Nachbau erfolgt in mehreren Schritten:
Code-Analyse: Ein erster Agent analysiert den vorhandenen Quelltext, erfasst Datenstrukturen, Kontrollflüsse und algorithmische Abläufe.
Spezifikationserstellung: Aus dieser Analyse erstellt das System eine funktionale Spezifikation, die Anforderungen, Schnittstellen und Logik präzise in Textform beschreibt.
Kontextbereinigung: Für die Programmierung startet eine neue Sitzung mit einem separaten Agenten. Dieser zweite Agent erhält ausschließlich die textuelle Spezifikation als Kontext; den ursprünglichen Quellcode sieht er nicht.
Autonome Implementierung: Anhand der Spezifikation schreibt der zweite Agent den Quellcode der Komponente neu.
Urheberrechtlich verlangt dieses Verfahren eine differenzierte Einordnung. Weil der erzeugte Code keine Kopie der Quelldateien darstellt und der ausführende Agent die Vorlage nicht im Kontextfenster hält, lässt sich eine Urheberrechtsverletzung über übereinstimmende Textstellen kaum nachweisen. Entscheidend wird damit die Detailtiefe der Spezifikation.
Bildet die Spezifikation interne Kontrollflüsse und algorithmische Details der Vorlage praktisch Zeile für Zeile ab, liegt ein Plagiat nahe. Beschränkt sich der Text hingegen auf Module, Schnittstellen und allgemeine Programmlogik, handelt es sich rechtlich um eine eigenständige Neuimplementierung.
Verhaltensbasierte Rekonstruktion im Blackbox-Verfahren
Das Blackbox-Cloning greift, wenn proprietäre Komponenten ohne Zugriff auf den Quellcode nachgebildet werden sollen. Um Nutzungsbedingungen oder gesetzliche Verbote bezüglich Dekompilierung und Binäranalyse einzuhalten, bleibt die Software als Binärdatei unangetastet.
Der Nachbau stützt sich rein auf externe Quellen:
Die Auswertung öffentlich verfügbarer Schnittstellendokumentationen und API-Beschreibungen.
Die Analyse von Leistungsbeschreibungen, typischen Verhaltensmustern sowie Ein- und Ausgabeformaten.
Die Formulierung einer funktionalen Spezifikation, die das beobachtbare Verhalten der Zielkomponente festlegt.
Die Definition externer Schnittstellen, damit sich das neue Modul direkt in das Gesamtsystem einfügt.
Die autonome Umsetzung durch einen KI-Agenten, meist gesteuert über Test-First-Verfahren, bei denen Tests das Soll-Verhalten vorgeben und der Code iterativ dagegen entwickelt wird.
Dieser Ablauf entspricht dem im Software-Engineering etablierten Clean-Room-Verfahren. Da niemand den geschützten Quelltext einsieht oder Binärcode dekompiliert, entstehen bei Komponenten mittlerer Komplexität funktionale Duplikate, ohne Schutzrechte am Quellcode zu berühren.
Konzeptschutz und Schöpfungshöhe von Quellcode
Die urheberrechtliche Bewertung dieser maschinellen Abläufe folgt den Grundsätzen der klassischen Softwareentwicklung. Analysiert ein Entwickler ein bestehendes Werkzeug, beispielsweise ein Hilfsprogramm für 10 US-Dollar, darf er dessen Funktionsweise nachvollziehen und eine eigene Anwendung mit gleichem Funktionsumfang schreiben.
Das gleiche Prinzip gilt bei komplexen Architekturen wie Content-Management-Systemen. Wer ein solches System aufbaut, orientiert sich an Marktstandards: Strukturierte Inhaltselemente, hierarchische Seitenbäume oder standardisierte Datenstrukturen werden als Konzepte übernommen und im eigenen Quelltext implementiert.
Darin liegt keine Urheberrechtsverletzung. Das Urheberrecht schützt weder abstrakte Ideen noch funktionale Prinzipien oder technische Mechanismen einer Software. Geschützt ist die konkrete sprachliche und logische Ausgestaltung, also die individuelle Schöpfungshöhe des Quellcodes.
Übernehmen KI-Agenten diese Schritte von der Verhaltensanalyse über die Spezifikation bis zum Schreiben des Codes, bleibt diese Rechtslogik unverändert. Sofern der erzeugte Code keine unmittelbare Kopie fremder Textpassagen darstellt, gilt er formal als eigenständiges Werk, das bekannte Anforderungen bedient.
Verschiebungen in der Verwertung von Schutzrechten
Das Zusammenspiel aus KI-gestützter Rekonstruktion und den Grenzen des Urheberrechts verändert die Position von Softwareherstellern spürbar.
Sinkende Durchsetzbarkeit: Sobald Entwickler Softwarekomponenten über Spezifikationen ad hoc und ohne direkten Code-Transfer neu erzeugen können, verliert das Copyright auf konkrete Quellcodezeilen seine Kontrollwirkung. Der Nachweis unzulässiger Übernahmen wird technisch wie juristisch aufwendig.
Erosion des Lizenzwerts: Ein Schutzrecht sichert die wirtschaftliche Verwertung, indem es Nachbauten verteuert oder unterbindet. Wenn der rechtskonforme Nachbau über Spezifikationen schneller, günstiger und risikoärmer gelingt als der Lizenzerwerb, verliert die Lizenz ihren wirtschaftlichen Wert.
Grenzen des bisherigen Schutzrahmens: Das Urheberrecht für Software entstand zu einer Zeit, als die Codeerstellung den größten Arbeits- und Kostenaufwand bedeutete. Wenn Agenten die Implementierung automatisieren, wandert der Wert von der Codezeile zum funktionalen Konzept. Da Konzepte nach geltendem Recht gemeinfrei bleiben, verliert das Urheberrecht an Steuerungsfunktion.
Treffen generative Systeme auf bestehende Rechtsnormen, verschiebt sich die Praxis. Wenn die Übertragung funktionaler Spezifikationen in lauffähige Software keinen nennenswerten manuellen Programmieraufwand mehr erfordert, greift der urheberrechtliche Schutz von Quellcodezeilen zunehmend ins Leere.
Hinweis zur Rechtslage
Dieser Artikel beschreibt technische Verfahren und ordnet sie aus Sicht der Softwareentwicklung ein. Er ist keine Rechtsberatung und ersetzt keine rechtliche Prüfung im Einzelfall.
Ob ein KI-gestützter Nachbau zulässig ist, hängt vom konkreten Fall ab: vom anwendbaren Recht, das sich zwischen Ländern deutlich unterscheidet, von den Lizenz- und Nutzungsbedingungen der Vorlage, von der Detailtiefe der Spezifikation und davon, wie der Nachbau tatsächlich entstanden ist. Hinzu kommt, dass KI-Modelle Code aus ihren Trainingsdaten wiedergeben können, auch wenn die Vorlage nicht im Kontext liegt. Für KI-gestützte Verfahren haben Gerichte viele dieser Fragen noch nicht entschieden.
Der Artikel empfiehlt keines der beschriebenen Verfahren. Wer fremde Software auf diesem Weg nachbauen will, sollte das Vorhaben vorher mit einer Anwältin oder einem Anwalt mit Schwerpunkt IT- oder Urheberrecht klären.
Das Werkzeug REA (Update)
Während dieser Artikel entstand, wurde auf GitHub ein Open-Source-Projekt bekannt, das einen Teil der beschriebenen Abläufe als fertiges Werkzeug bereitstellt. REA steht für „Reverse Engineer Anything“. Es ist ein MCP-Server mit eigener Kommandozeile, über den Coding-Agenten wie Claude Code, Codex, Cursor oder Gemini CLI fremde Software untersuchen: native Programme, Electron- und JavaScript-Anwendungen, .NET-Assemblies, Android-Apps und Websites. Für native Programme bindet REA Disassembler und Decompiler wie Ghidra, Hopper oder IDA an. Der Agent erhält Pseudocode, Symbole, Aufrufbeziehungen und beobachtetes Laufzeitverhalten. Daraus kann er eine eigene Implementierung schreiben und sie gegen das Original testen.
Das Repository liegt unter github.com/morluto/rea und existiert seit April 2026. Die erste Version erschien im Juli, inzwischen liegt Version 6.5 vor. Initiator ist ein Entwickler, der unter dem Namen morluto auftritt; neben ihm arbeiten rund hundert weitere Personen mit. Bekannt wurde REA Anfang Oktober, als das Projekt nach Angaben von daily.dev in etwa einer Woche mehr als 100.000 Sterne sammelte. Mitte Oktober waren es rund 254.000. Der Code steht unter MIT-Lizenz.
In der Einteilung dieses Artikels gehört REA zu keinem der beiden Verfahren. Das Blackbox-Verfahren lässt die Binärdatei unangetastet; REA setzt genau dort an und dekompiliert sie. Der Agent sieht dann zwar nicht den Quelltext, aber eine aus dem Binärcode rekonstruierte Fassung davon. Damit berührt das Werkzeug den Punkt, den das Blackbox-Verfahren vermeiden will: Das deutsche Urheberrecht erlaubt das Dekompilieren nur in engen Grenzen, vor allem um Interoperabilität herzustellen (§ 69e UrhG). REA selbst schließt in seinem Disclaimer aus, proprietäre Software zu kopieren oder geschützten Code nachzubilden. Als Zwecke nennt das Projekt Sicherheitsforschung, Interoperabilität, Softwareerhalt und die Analyse von Software, die man besitzt oder untersuchen darf.