
Begriffe aus der KI-Welt: Tokens
Sprachmodelle lesen und schreiben in Tokens, und in Tokens wird auch abgerechnet: Bei Claude Opus 5.5 kostet eine Million Input-Tokens 4 $, eine Million Output-Tokens 20 $. Am Beispiel Claude geht es hier um die Sorten von Tokens, um das, was Bilder, PDFs und Videos verbrauchen, und um einen Agenten mit 20 Runden, bei dem Caching die Kosten für Systemanweisung und Werkzeuge von 1,60 $ auf rund 0,18 $ senkt. Das Prinzip gilt bei allen Anbietern, nur die Preise unterscheiden sich.
Ein Token ist ein Stück Text, wie es ein Sprachmodell liest und schreibt: mal ein ganzes Wort, mal eine Silbe oder ein Wortstück, mal ein Satzzeichen. Fast alles, was ein KI-Agent tut, kostet und begrenzt, wird in dieser Einheit gemessen.
Was ist ein Token?
Ein Sprachmodell rechnet nur mit Zahlen. Damit Text hineinkommt, braucht es eine Übersetzung: Ein Tokenizer zerlegt den Text in Stücke und ersetzt jedes Stück durch seine Nummer in einem festen Vokabular. Diese Stücke sind die Tokens. Buchstaben und Wörter sieht das Modell nie, nur die Folge der Nummern.
Buchstaben wären als Einheit zu klein: Ein Text würde zu einer sehr langen Folge, in der das einzelne Zeichen kaum etwas bedeutet. Ganze Wörter wären zu groß: Das Vokabular müsste jedes Wort jeder Sprache in jeder Form enthalten, und ein neues Wort ließe sich gar nicht darstellen. Tokens liegen dazwischen. Das Vokabular wird vorab aus großen Textmengen gelernt. Was häufig vorkommt, bekommt einen eigenen Eintrag, etwa „und“ oder „ich“; seltene Wörter werden aus mehreren Stücken zusammengesetzt. Heutige Vokabulare haben Zehntausende bis über hunderttausend Einträge.
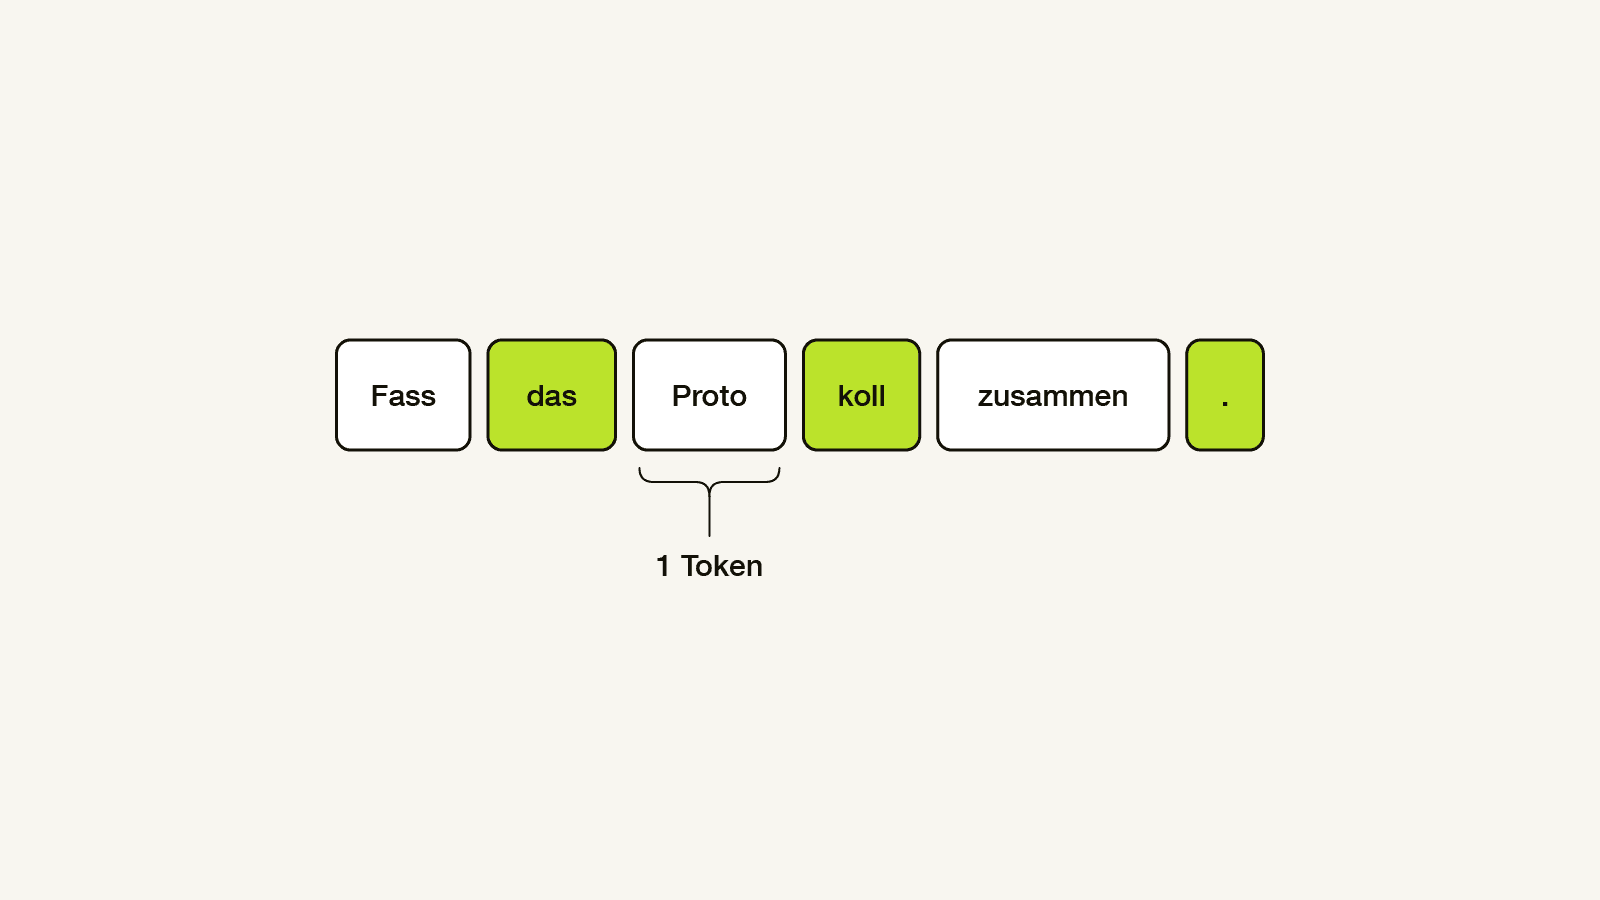
Ein Satz wie „Die Kundenzufriedenheitsumfrage läuft.“ könnte etwa so zerlegt werden: Die · Kunden · zufrieden · heits · umfrage · läuft · . Das sind sieben Tokens für drei Wörter. Wie genau zerlegt wird, hängt vom Modell ab; den Tokenizer von Claude hat Anthropic nicht veröffentlicht.
Auch die Antwort entsteht Token für Token. Das Modell sagt das nächste Token voraus, hängt es an und sagt das nächste voraus, bis die Antwort fertig ist. Deshalb werden auch Antworten in Tokens gezählt, und eine lange Antwort dauert länger als eine kurze.
Ein Token ist damit der kleinste Baustein, mit dem das Modell arbeitet. Mit Bedeutung haben seine Grenzen wenig zu tun: „heits“ bedeutet für sich nichts. Zur Orientierung nennt Anthropic eine Faustregel: Ein Token entspricht im Englischen etwa 4 Zeichen oder drei Vierteln eines Worts. Deutsch braucht mehr, weil lange Komposita zerteilt werden und die Vokabulare vor allem auf Englisch ausgelegt sind. Derselbe Inhalt kostet auf Deutsch also mehr. Auch zwischen Modellen lassen sich Tokens nicht direkt vergleichen: Laut Anthropic erzeugen die Modelle ab Claude 4.7 mit einem neuen Tokenizer für denselben Text etwa 30 % mehr Tokens als frühere Modelle.
Die Einheit hinter Preis und Kontext
An der Zahl der Tokens hängt, was ein Aufruf leisten kann und was er kostet:
Kontextfenster: Wie viel Text ein Modell auf einmal berücksichtigt, wird in Tokens angegeben. Dazu folgt ein eigener Beitrag in dieser Reihe.
Kosten: Abgerechnet wird pro Million Tokens, getrennt nach Sorte.
Latenz: Wie schnell die Antwort kommt, hängt an der Zahl der Tokens.
Limits: Rate Limits und Obergrenzen der Anbieter greifen ebenfalls in Tokens.
Input, Output, Reasoning, Cache
Die folgenden Zahlen stammen aus der Preisliste von Anthropic (Stand Oktober 2026) und gelten für Claude Opus 5.5. Claude dient hier nur als Beispiel. Andere Anbieter rechnen nach demselben Prinzip, mit anderen Preisen.
Input-Tokens sind alles, was das Modell bei einem Aufruf liest: Systemanweisung, Werkzeugbeschreibungen, der bisherige Verlauf, angehängte Dateien. Preis: 4 $ pro Million Tokens. Für Agenten ist eine Eigenschaft entscheidend: Das Modell hat zwischen den Aufrufen kein Gedächtnis. Bei jeder neuen Nachricht liest es den ganzen Verlauf erneut, und er wird erneut bezahlt.
Output-Tokens sind das, was das Modell schreibt. Sie kosten 20 $ pro Million, fünfmal so viel wie Input.
Reasoning-Tokens entstehen beim „Nachdenken" vor der Antwort und werden als Output abgerechnet. Angezeigt wird oft nur eine Zusammenfassung, bezahlt wird das ganze Denken. Bei neueren Modellen bleibt das Denken außerdem im Verlauf und zählt beim nächsten Aufruf noch einmal als Input.
Cache-Tokens betreffen den Anfang eines Aufrufs, der sich wiederholt, typischerweise Systemanweisung und Werkzeuge. Diesen Teil speichert der Anbieter zwischen. Das erste Speichern ist etwas teurer als normaler Input: 5 $ pro Million Tokens bei 5 Minuten Haltedauer, 8 $ bei einer Stunde. Jeder Treffer danach kostet 0,20 $ pro Million, ein Zwanzigstel des normalen Input-Preises. Bei vielen anderen Claude-Modellen ist es ein Zehntel.
Ein einzelner Aufruf setzt sich also aus mehreren Posten zusammen: gecachter oder frischer Input für den festen Vorspann, normaler Input für den Verlauf, Output und Reasoning für die Antwort.
Caching entscheidet über die Agenten-Rechnung
Am deutlichsten zeigt sich der Unterschied bei einem Agenten, der in Schleifen arbeitet. Angenommen, er braucht mit Claude Opus 5.5 genau 20 Runden für eine Aufgabe. Systemanweisung und Werkzeugbeschreibungen umfassen zusammen 20.000 Tokens und stehen am Anfang jedes Aufrufs.
Ohne Cache:
20 Aufrufe × 20.000 Tokens = 400.000 Input-Tokens
zu 4 $ pro Million: 1,60 $
Mit Cache:
einmal schreiben: 20.000 Tokens zu 5 $ pro Million = 0,10 $
19-mal lesen: 380.000 Tokens zu 0,20 $ pro Million = rund 0,08 $
zusammen: rund 0,18 $, etwa ein Neuntel
Der Cache greift allerdings nur auf den gleichbleibenden Anfang. Der Verlauf wird jede Runde länger und jede Runde neu gelesen, und Output- und Reasoning-Tokens bleiben die teuersten Posten. Eine Agenten-Session kostet nach einer Stunde deshalb spürbar mehr als eine einzelne Frage. Ohne Caching kommt ein Agent kaum aus; rechnerisch lohnt es sich schon ab dem zweiten Aufruf.
Token-Verbrauch während einer Session
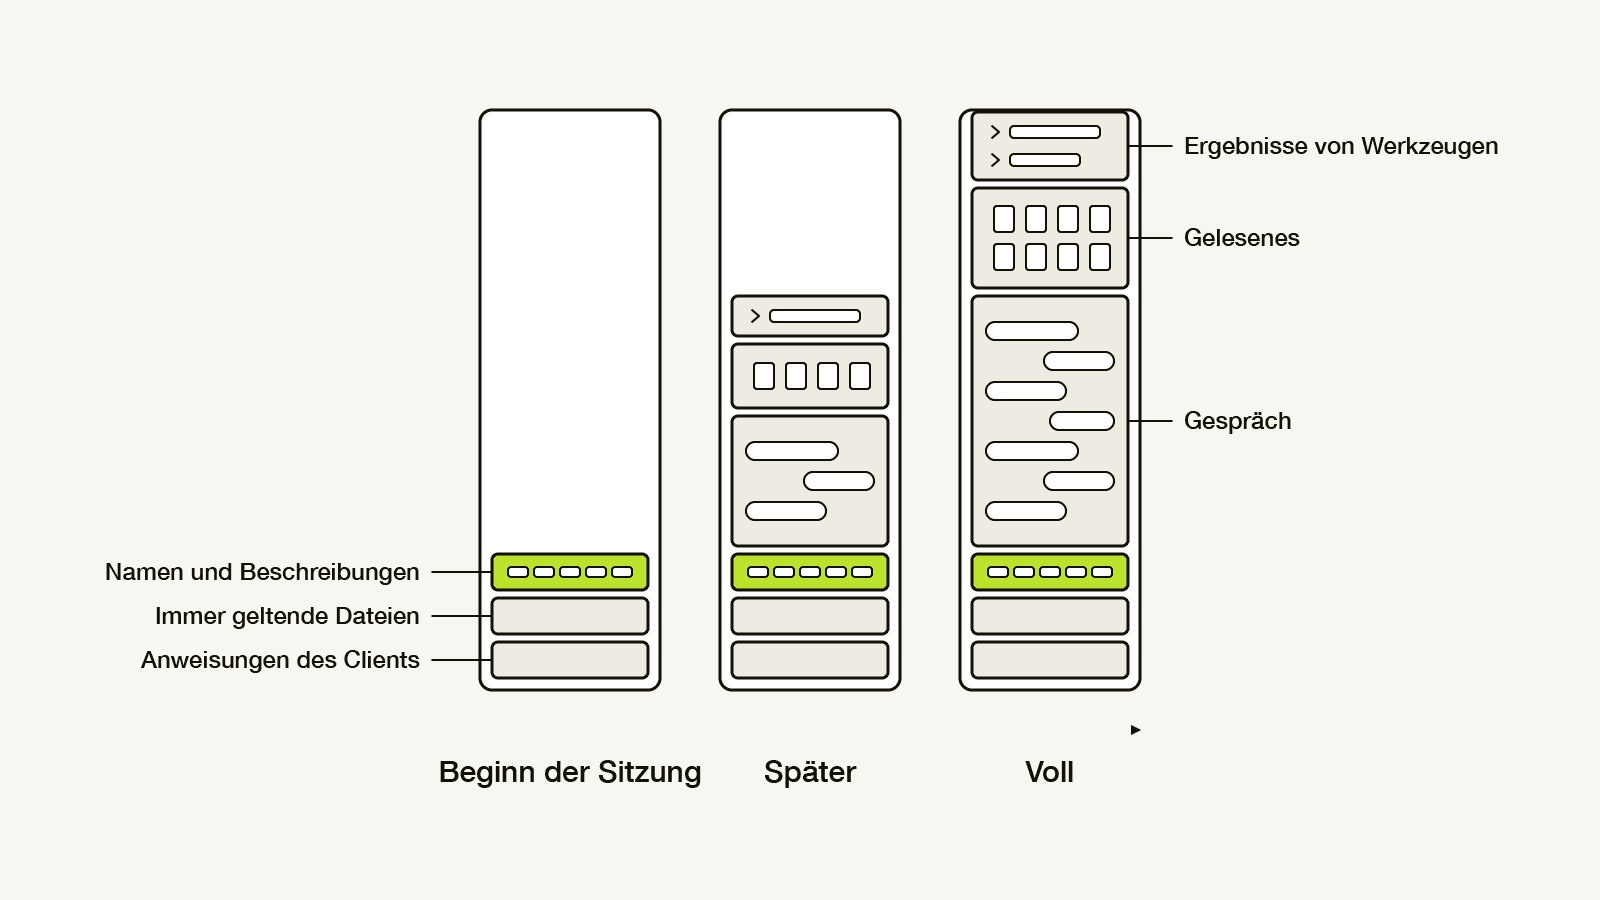
Schon vor der ersten Frage ist der Kontext einer Sitzung nicht leer. Unten liegt ein fester Sockel: die Anweisungen des Clients, also der Anwendung, über die das Modell arbeitet, dazu Dateien, die in jeder Sitzung gelten, etwa eine CLAUDE.md, und die Namen und Beschreibungen aller Skills und Werkzeuge. Dieser Sockel bleibt die ganze Sitzung über gleich und ist genau der Teil, den der Cache abfängt.
Darüber wächst, was die Arbeit erzeugt: das Gespräch selbst, jede Datei, die der Agent liest, und jedes Ergebnis eines Werkzeugs, etwa eine Liste von Suchtreffern oder die Ausgabe eines Befehls. Nichts davon fällt von allein wieder heraus. Weil das Modell bei jedem Aufruf den ganzen Kontext neu liest, kostet jede Runde mehr als die vorige, bis das Kontextfenster voll ist. Dann muss der Client Platz schaffen, etwa indem er den bisherigen Verlauf zusammenfasst und mit der Zusammenfassung weiterarbeitet.
Bilder, PDFs und Videos
Auch nicht-textuelle Eingaben werden in Tokens gemessen, nur anders zerlegt.
Bilder bei Claude: Das Modell zerlegt ein Bild in Kacheln von 28 × 28 Pixeln, jede Kachel ist ein Token. Ein Bild von 1000 × 1000 Pixeln ergibt 1.296 Tokens. Ein Full-HD-Screenshot (1920 × 1080) kommt bei den neueren Modellen auf 2.691 Tokens, bei Claude Opus 5.5 also gut einen Cent. Größere Bilder werden vorher verkleinert. Ein Bild kostet deshalb höchstens 4.784 Tokens ab Claude 4.7 und höchstens 1.568 bei älteren Modellen (Vision-Doku).
PDFs bei Claude: Jede Seite geht zweimal ein, als extrahierter Text (laut Anthropic typischerweise 1.500 bis 3.000 Tokens pro Seite) und als Bild der Seite, das wie jedes andere Bild berechnet wird (PDF-Doku).
Bilder erzeugen: Claude erzeugt keine Bilder. Bildmodelle anderer Anbieter rechnen ein erzeugtes Bild als Output-Tokens ab. Bei Google verbraucht Gemini 3 Pro Image für ein Bild bis 2048 × 2048 Pixel 1.120 Tokens, zu 120 $ pro Million Bild-Tokens, also rund 13 Cent pro Bild (Gemini-Preise).
Videos: Claude liest keine Videos. Gemini zerlegt ein Video in Einzelbilder, standardmäßig eines pro Sekunde, plus Tonspur. Das ergibt laut Google etwa 263 Tokens pro Sekunde, eine Minute Video also rund 16.000 Tokens (Gemini-Tokens). Videogeneratoren rechnen meist pro Sekunde erzeugtem Video ab statt in Tokens.
Für Agenten, die Screenshots auswerten oder Dokumente durchsuchen, ist ein mitgeschicktes Bild damit ein normaler Input-Posten. Solange es im Verlauf bleibt, steht es in jeder weiteren Runde wieder auf der Rechnung.
Was die Zählung offenlegt
Wer in Tokens rechnet, sieht die Kostenstruktur eines Agenten: ein fester Vorspann, der sich cachen lässt, ein Verlauf, der mit jeder Runde wächst, und eine Antwort, die pro Token fünfmal so viel kostet wie die Eingabe. Technisch ist daran nichts Kompliziertes. Die Rechnung entsteht aus Wiederholung, und an der Wiederholung setzt jede Optimierung an.