
BrightSync: eine komplette Plattform mit KI entwickelt
Für eine deutsche Forschungsorganisation haben wir eine Plattform aufgebaut, die Forschende für externe Wirtschaftsanfragen intern zusammenstellt. Vom Transkript des Anforderungsworkshops bis zur Umsetzung von gut 150 Tickets lief der Prozess fast vollständig über KI-Agenten. Nach vier Wochen Pilotbetrieb läuft das System ohne eine einzige Fehlermeldung.
Ein Kundenprojekt aus diesem Jahr, welches wir von der ersten Anforderung bis zum Betrieb durchgehend AI-native umgesetzt haben. Es hat deutlich weniger gekostet als ein klassisch aufgesetztes Softwareprojekt dieser Größe, und die Qualität ist dennoch höher. Der erste Release ging ohne einen einzigen echten Bug live.
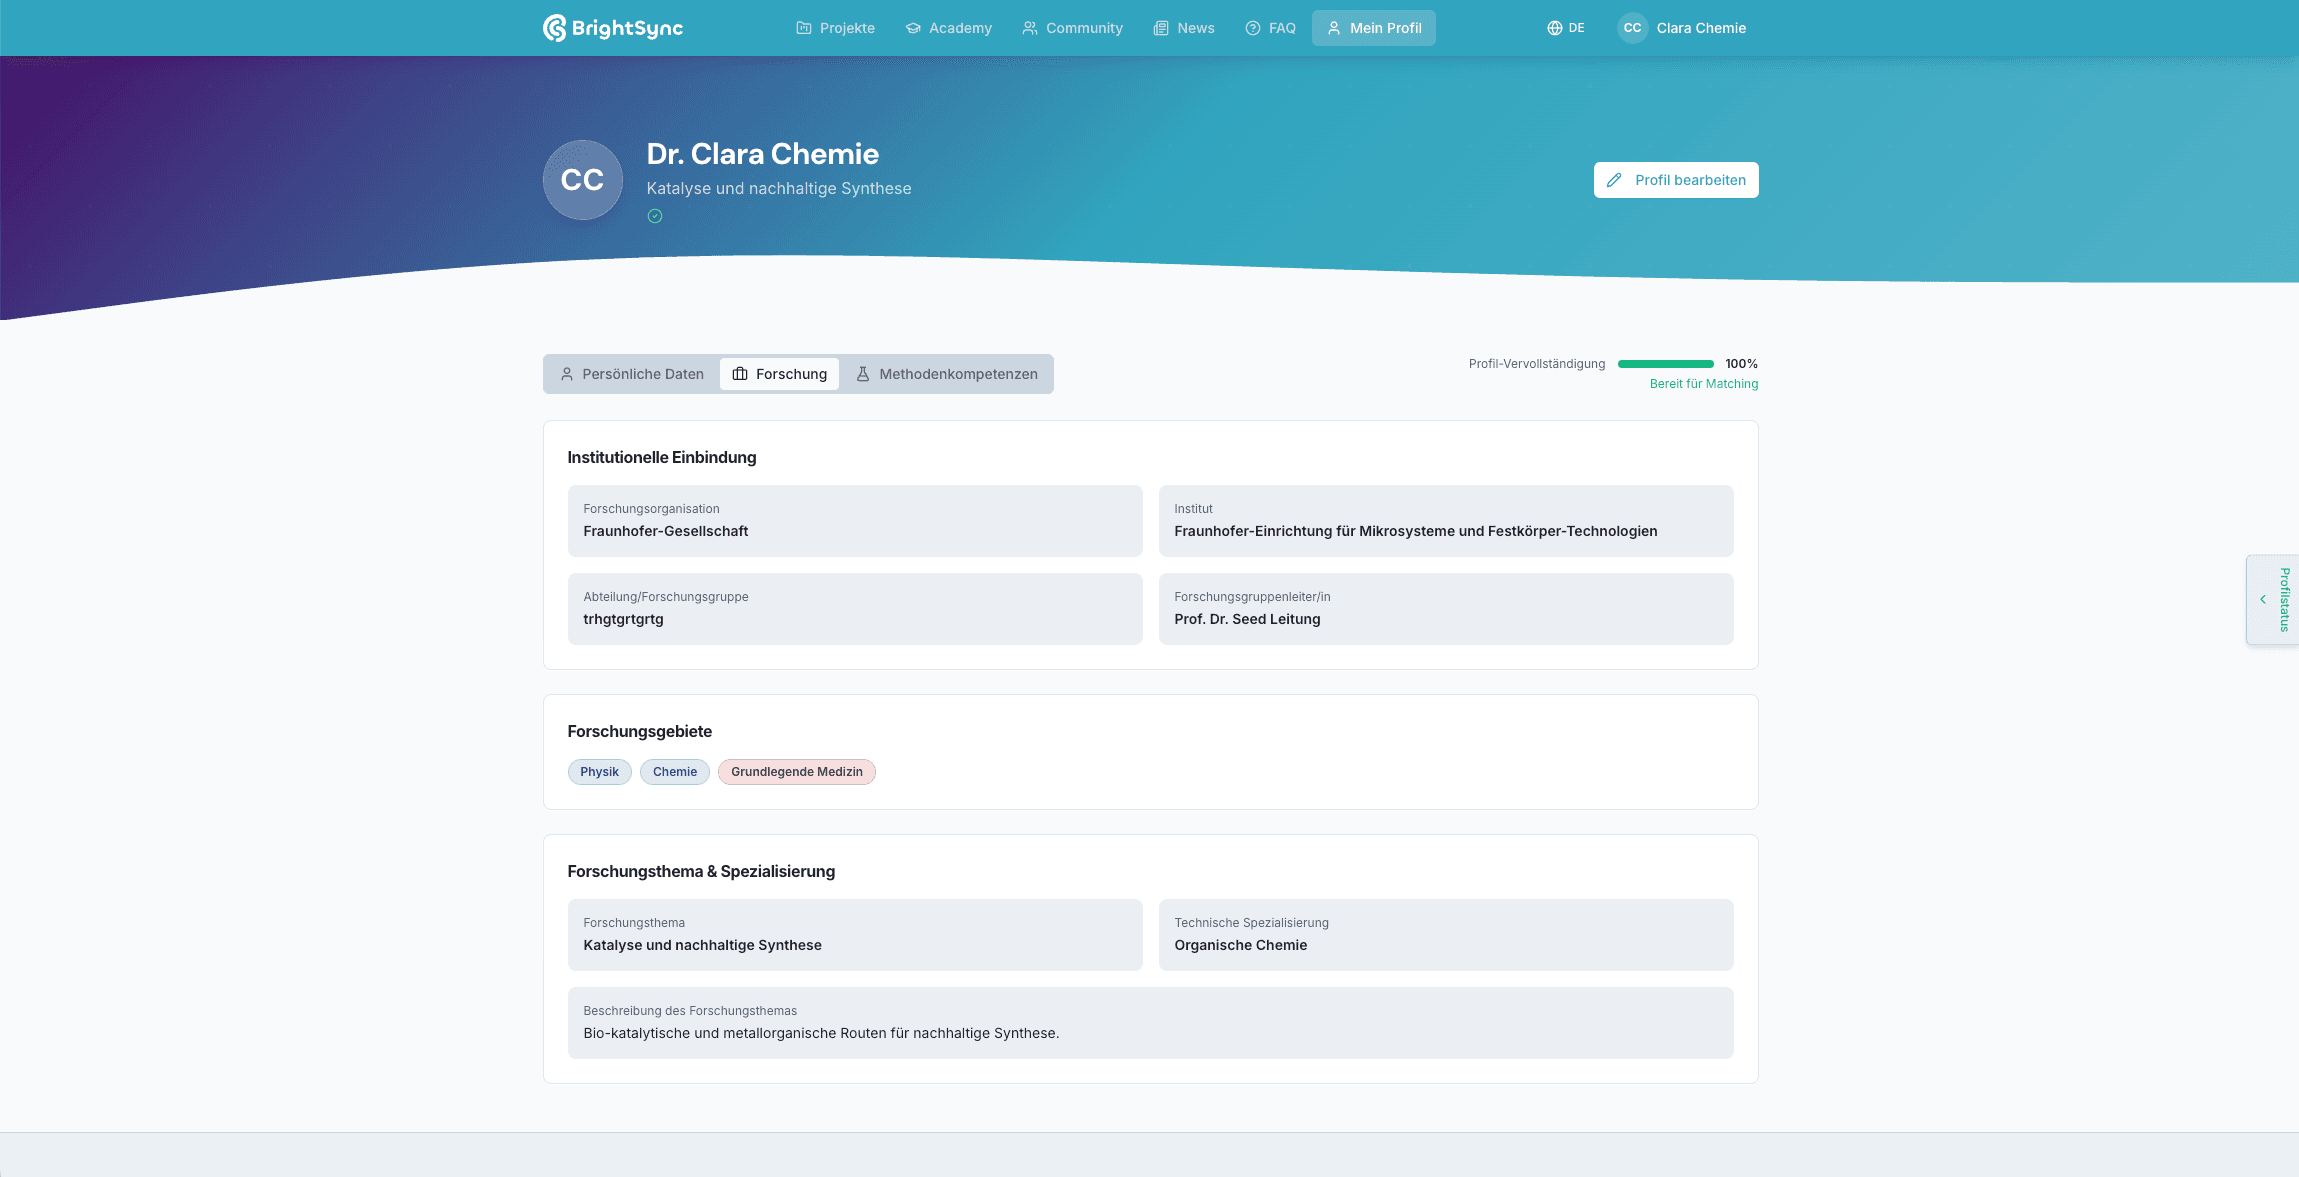
Der Kunde ist ein Start-up aus dem Inkubator der Max-Planck-Gesellschaft, das Wissenschaft und Industrie zusammenbringt. Kern der Plattform ist ein geschützter Talentpool. Forschende, vom Doktoranden bis zur Institutsleitung, hinterlegen dort ihre Forschungsgebiete, ihre Expertise und wie viel Zeit sie für Projekte frei haben. Daneben steht ein Katalog mehrerer hundert deutscher Forschungseinrichtungen, von Fraunhofer und Max Planck bis zu den Universitäten. Jede davon ist über eine mehrstufige Taxonomie verschlagwortet, die von den OECD-Wissenschaftsfeldern bis zur konkreten Fachkompetenz reicht. Geht eine Anfrage aus der Industrie ein, sucht das Team in beiden Beständen gezielt und stellt daraus Projektteams zusammen. Die Institute pflegen ihre Einträge selbst, auf Wunsch auch über eine Schnittstelle für KI-Agenten. Eine Academy bereitet Forschende auf den Schritt aus der Wissenschaft in die Praxis vor.
Datenschutz war dabei die zentrale Vorgabe. Die Profile durften keinesfalls öffentlich im Netz stehen. Das Matching der Personen sollte kuratiert im Hintergrund ablaufen, gesteuert durch das interne Team.
Ein solches Projekt bindet üblicherweise über Monate hinweg Entwicklerkapazitäten und kostet entsprechend viel Geld. Wir haben den Weg von der ersten Skizze bis zur produktiven Software fast vollständig über KI-Agenten abgewickelt.
Anforderungsanalyse aus dem Protokoll
Am Beginn stand ein mehrstündiger Anforderungsworkshop. Wir haben das Gespräch vollständig aufgezeichnet und Wort für Wort transkribieren lassen. Auf dieser Basis arbeitete die KI die Spezifikationen in mehreren Stufen heraus. Zuerst entstand eine knappe Systemvision. Darauf folgte ein Datenmodell, das die Entitäten und deren Beziehungen festlegte. Anschließend definierte das System die einzelnen Arbeitsabläufe und grobe Entwürfe für die Benutzeroberflächen.
Das Vorgehen folgte klassischer Software-Methodik. Der Unterschied lag in der Zeit: Die Aufbereitung dauerte wenige Stunden statt mehrerer Wochen.
Aus diesen Vorgaben generierte das System automatisch die Arbeitspakete für die Entwicklung. Gut 150 einzelne Tickets landeten im Projektmanagement. Jedes Ticket wurde von der KI selbstständig ausformuliert und mit klaren Akzeptanzkriterien versehen. Bei ungenauen Annahmen oder fehlenden Informationen stellte das Modell Rückfragen an uns. Wir haben diese Lücken beantwortet, danach setzte die KI die 150 Tickets im Code um. Testdriven selbstverständlich.
Die AI Contextprocessing Engine: Volve
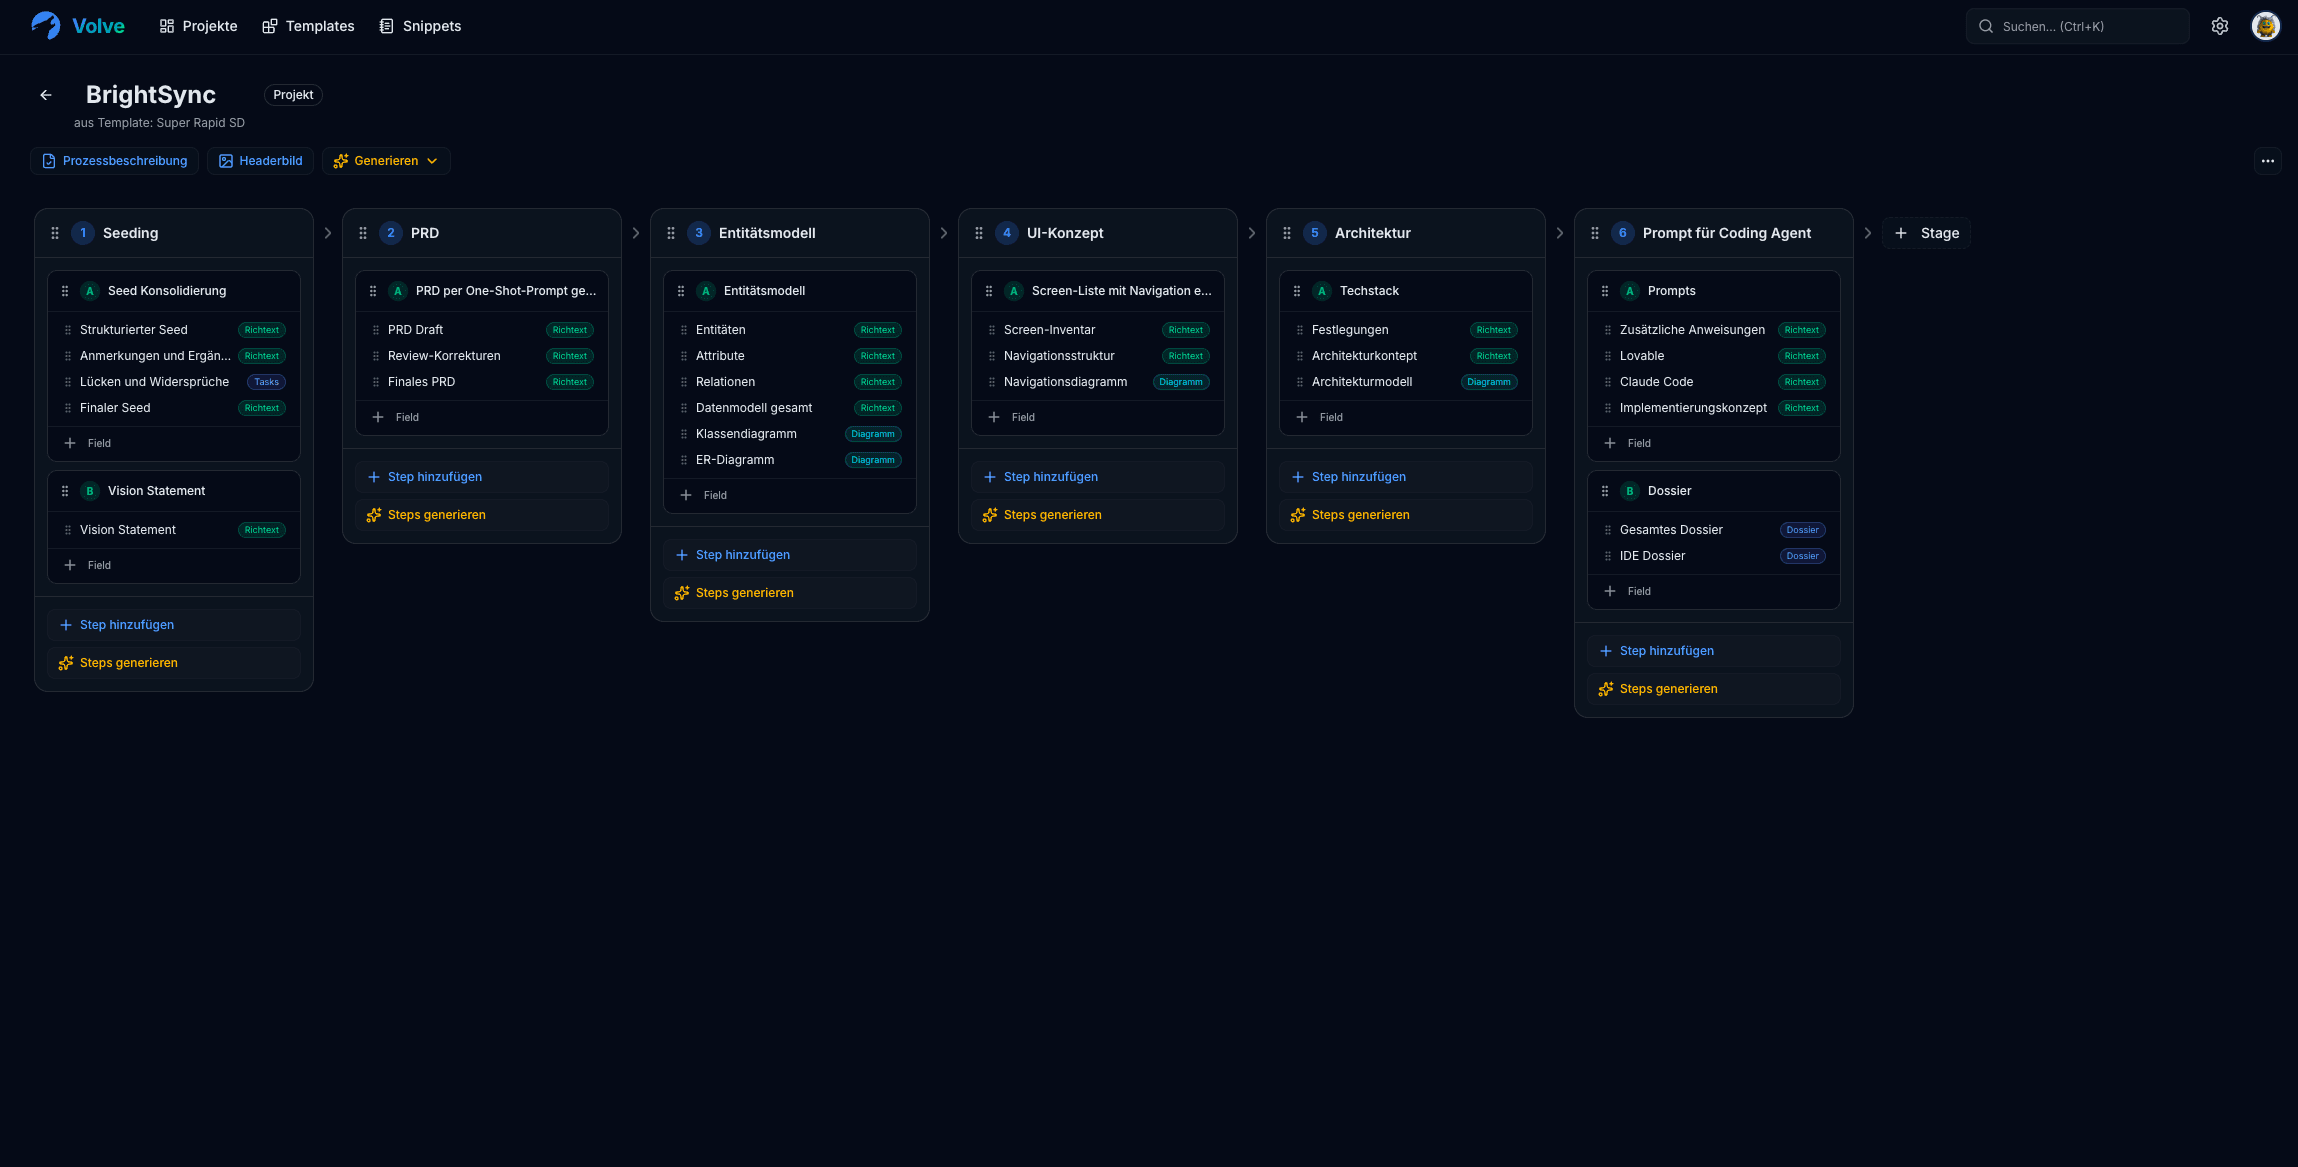
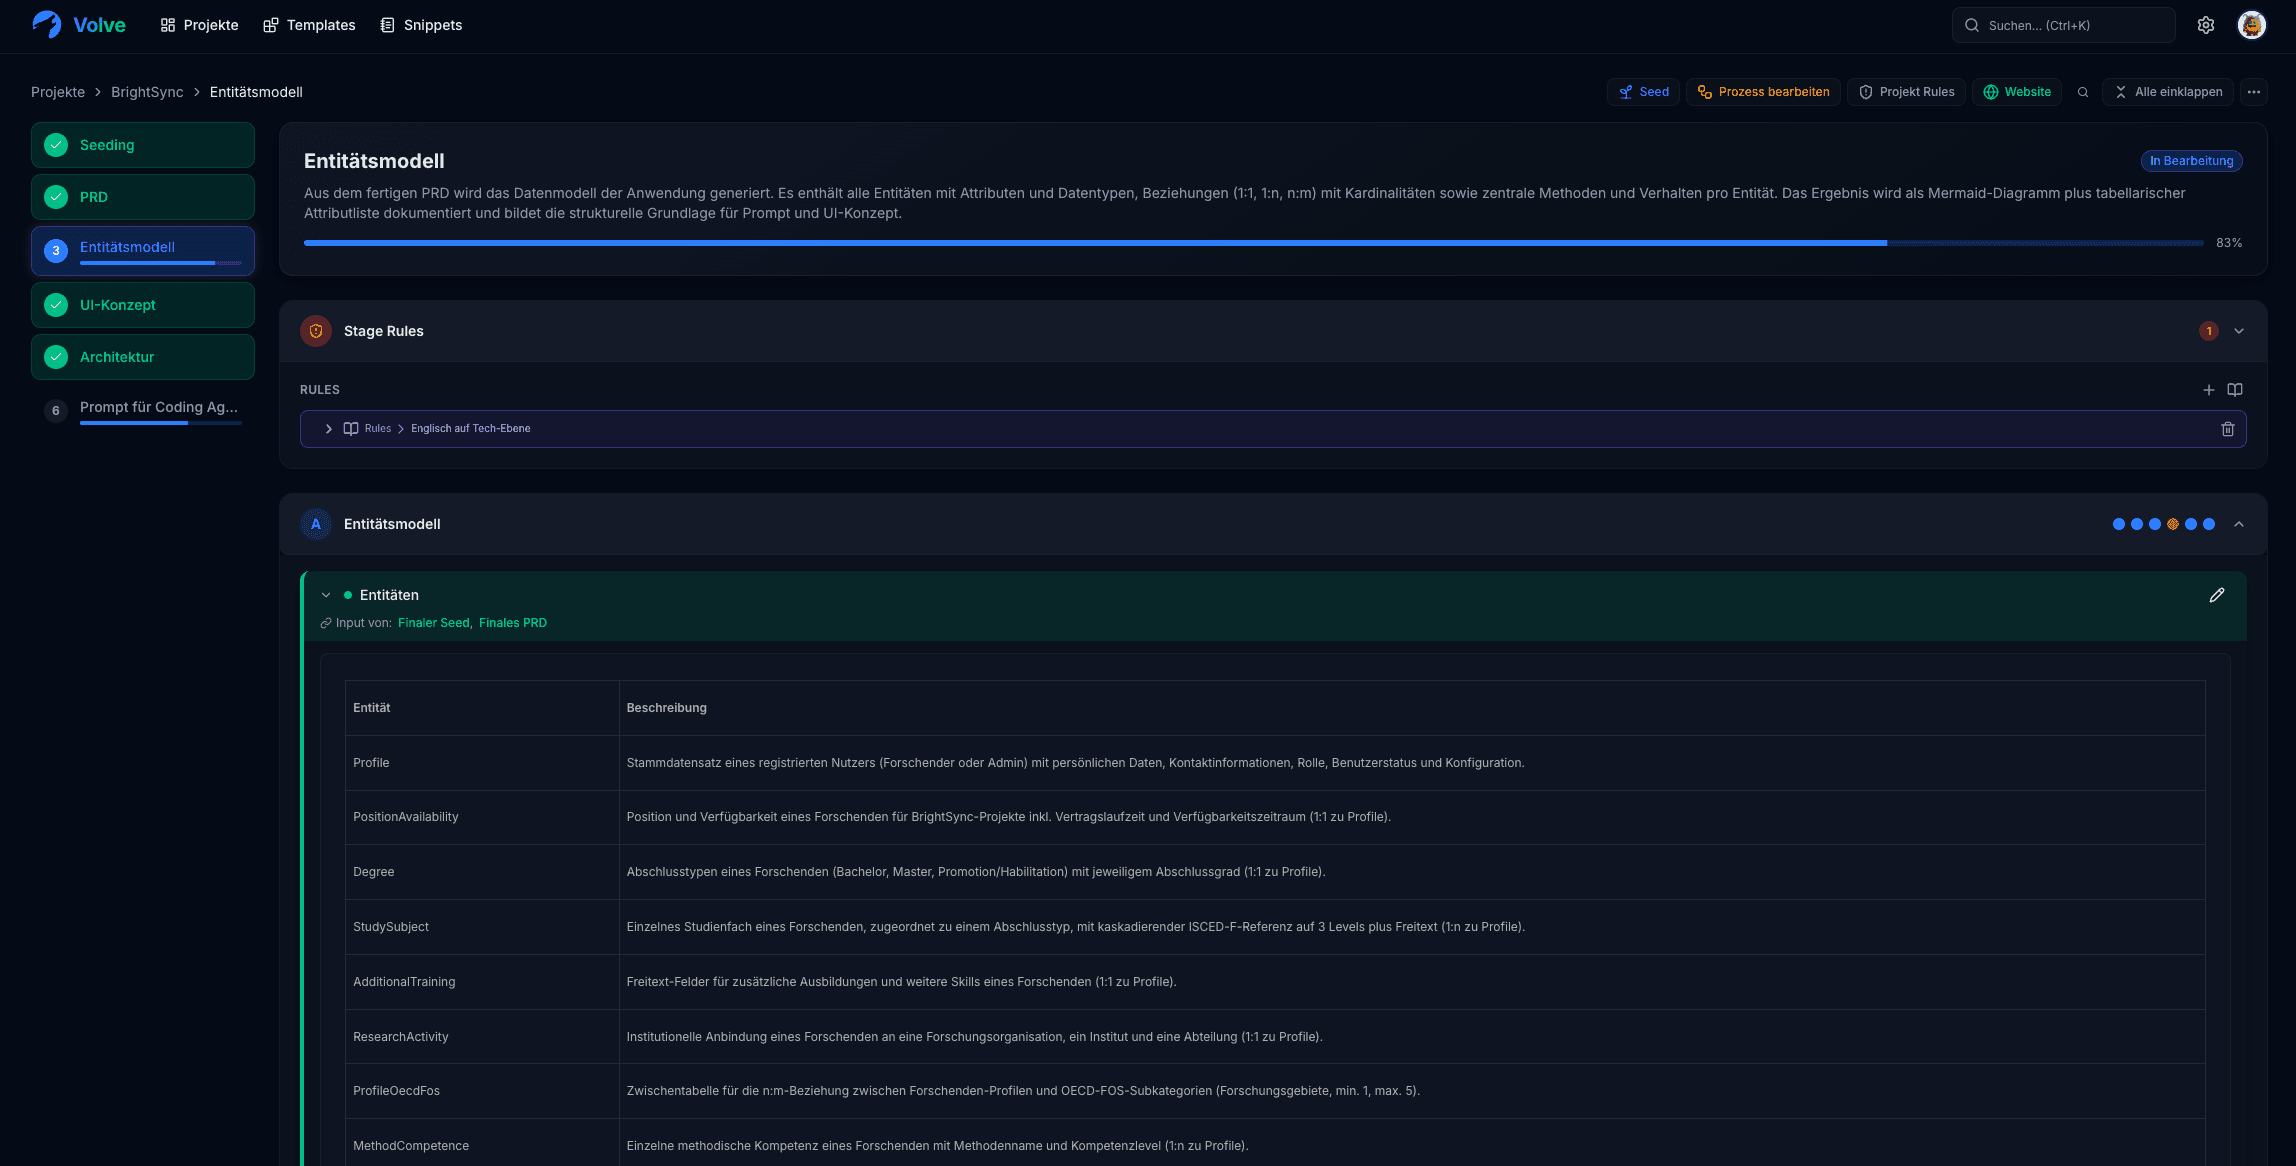
Wir haben ein Tool, welches uns die gesamte Kette der klassischen Anforderungskonzeptionen vollständig KI-basiert abbildet. Hinter jedem Prozessschritt sitzen hochspezialisierte Prompts und die verschiedenen Artefakte, die hier generiert werden, schließen in einem konfigurierten Abhängigkeitsgraphen jeweils als Kontext in die Folge-Artefakte ein. Man kann das natürlich auch per Hand mit Claude-Code machen oder anderen KI-Harnissen. Bemerkenswert ist hier jedenfalls, dass wir das klassische Requirements Engineering wieder ausgegraben haben und hier wirklich nach alter Schule, wasserfallmäßig, bis ins letzte Detail Anforderungen definieren.
Vier Wochen Betrieb ohne Fehler
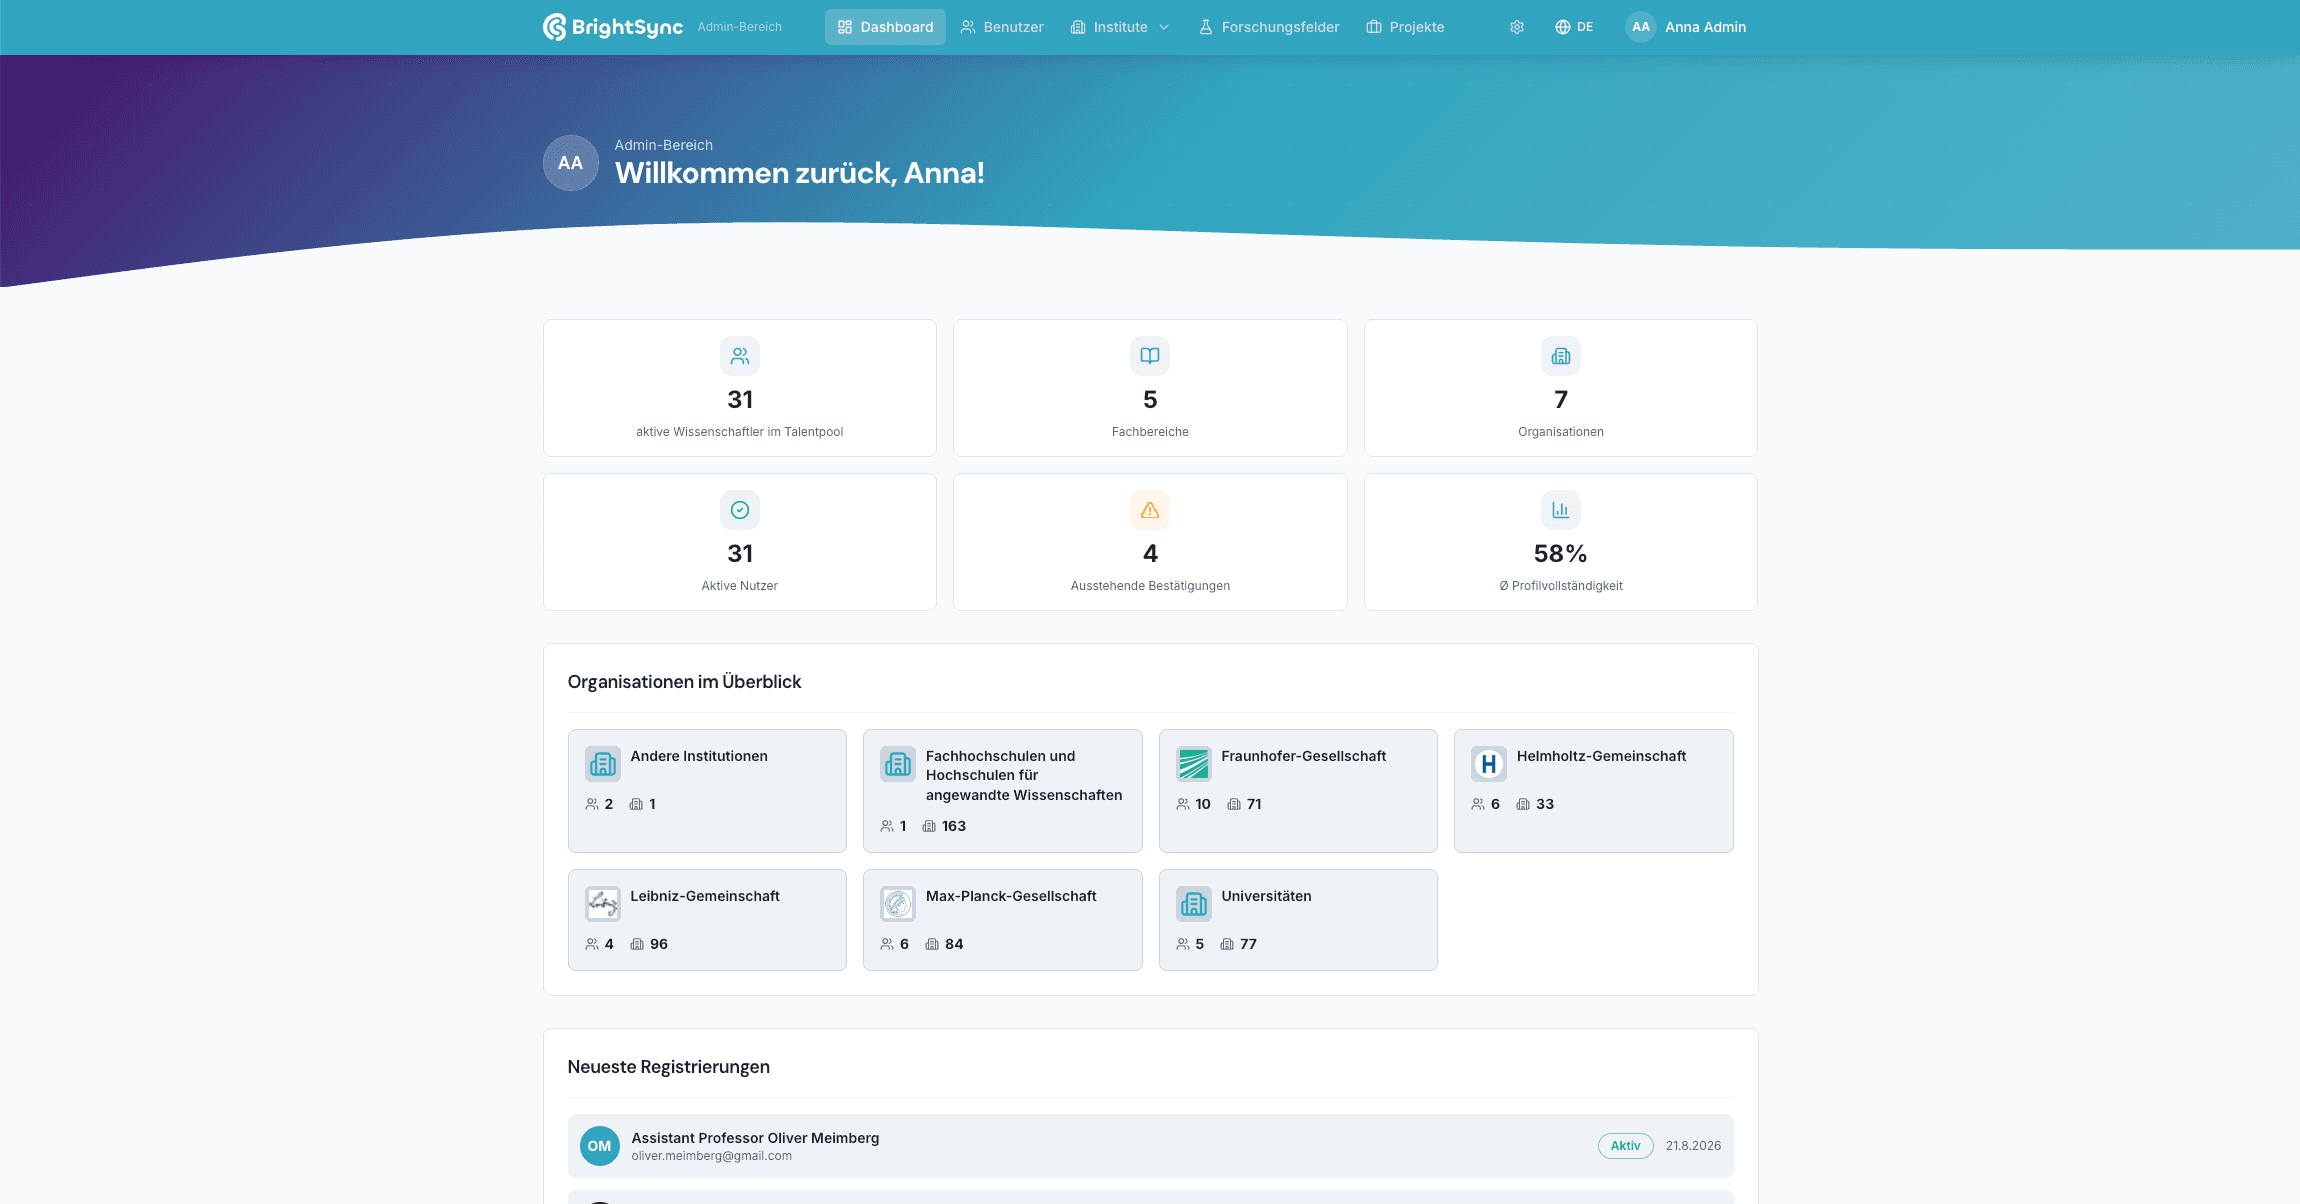
Die Plattform ging unter dem Namen BrightSync online. Nach 4 Wochen Pilotbetrieb mit echten Nutzern verzeichneten wir keine einzige Fehlermeldung durch den Kunden. Die Fachabteilung nutzt das System produktiv für das Team-Matching und hat gegenüber einem traditionell aufgesetzten Projekt einen erheblichen Teil des Budgets eingespart.
Während dieser ersten 4 Wochen lief eine direkte Rückmeldeschleife. Änderungswünsche an Texten oder Details in den Eingabemasken wurden erfasst, direkt in kleinere Arbeitspakete überführt, von der KI abgearbeitet und eingespielt. Der Weg von der Rückmeldung des Nutzers bis zum Update auf dem Server dauerte oft nur Minuten.
Sicherheitsstandards im Hintergrund
Software, die primär mit KI geschrieben wird, darf an der Infrastruktur keine Abstriche machen. BrightSync läuft unter denselben Betriebsbedingungen, die wir für jedes andere Unternehmenssystem ansetzen.
Die Auslieferung erfolgt über eine automatisierte Pipeline. Jeder Commit durchläuft automatisierte Tests, bevor er getrennt auf eine Staging-Umgebung oder das Produktivsystem aufgespielt wird. Der Server ist nach außen hin minimal exponiert. Bis auf die notwendigen Ports blockiert eine Firewall den Zugriff. Verbindungen laufen über verschlüsselte Protokolle mit Zertifikaten, die sich automatisch verlängern. Passwörter, API-Tokens und kryptografische Schlüssel liegen strikt getrennt von der Codebasis in Umgebungsvariablen.
Die Datenbank arbeitet mit restriktiven Berechtigungen. Sensible Profildaten lassen sich ausschließlich über serverseitige Logik abrufen und verlassen das geschützte Netz nicht unkontrolliert. Automatische Backups und kontinuierliche Statusprüfungen der Prozesse sichern den laufenden Betrieb ab. Es handelt sich um ein solides Standard-Setup, wie man es in der Praxis erwartet.
Die Rolle erfahrener Entwickler
Der Verlauf dieses Projekts zeigt, wie sich die Arbeit in der Softwareentwicklung verschiebt. Die Ausführung lag fast durchgehend bei der KI, von der Auswertung des ersten Gesprächs bis zum geschriebenen Quellcode für 150 Arbeitspakete.
Die Verantwortung für Systemarchitektur, Datenschutzkonzepte und die Belastbarkeit der Infrastruktur bleibt beim Menschen. Eine KI kann Code sehr schnell generieren, aber sie haftet nicht für das Ergebnis und versteht den betrieblichen Kontext nicht. Werkzeuge übernehmen das Tippen, Entwickler verantworten das System.
Die Qualität ist am Ende besser als bei traditionellen Software-Projekten.
Und vollständig anders als traditionell niedrig-budgetierte Softwareprojekte: Hier haben wir nicht mit Features gespart. Es wurden jede Menge Dinge umgesetzt und gebaut, die traditionell eigentlich nicht im Budget gewesen wären: kleine Quality-of-Life-Enhancements, Features und UX-Verbesserungen, die wir von Hand so sicherlich nicht gebaut hätten. Es sind einfach die Kleinigkeiten, die man in knapp budgetierten Softwareprojekten üblicherweise nicht mitmacht, einfach weil sie nicht im Budget sind. Ob das nun ein besonders schöner Selector ist oder eine Farbmarkierung bei komplexen Semantiken oder diverse Konfigurationsmöglichkeiten von Datntabellen im Frontend. Wir haben vieles einfach so mitgebaut, einfach nur weil es besser ist und uns nicht mehr als ein Lächeln und einen Prompt gekostet hat.
Am Ende muss man sagen: Die Qualität des Softwareproduktes ist aus UX-Sicht, Feature-Reichtum wie auch aus Architektur- und Security-Sicht um einiges höher als ich es häufig bei handgestrickten Softwarelösungen gesehen habe. Es ist beeindruckend zu sehen, was herauskommt, wenn erfahrene Senior Engineers mit einem hochwertigen LLM und einem gut trainierten Agent OS echtes Engineering betreiben.
Test-Driven Development ist hier Pflichtübung
Die Qualität ist auch deswegen so hoch, weil wir einfach eine starke Testabdeckung hatten. Hierbei ist das Schreiben von einigen tausend Tests, von Unitests über Integrations- sowie E2E-Tests, mit agentischer Hilfe natürlich auch viel einfacher zu realisieren als bei handgestrickter Software.
Und was sagt der Kunde?
Der Kunde ist nach eigenen Aussagen super zufrieden. Das Ganze war möglich mit einem Budget, welches um ein Mehrfaches unter dem lag, was wir als professioneller Softwaredienstleister mit klassischen Methoden benötigt hätten. Das kommt einem Early-Stage-Startup wie BrightSync natürlich in einer so frühen Phase sehr entgegen.
Über BrightSync: Forschung und Industrie zusammenbringen
In Deutschland arbeiten Tausende Forschende an Fragen, die für Unternehmen direkt relevant wären. Die Unternehmen erfahren davon selten. Gerade kleinen und mittleren Betrieben fehlt die interne Expertise, um ein technisches Problem selbst zu lösen, und oft auch der Zugang zur Wissenschaft, um die richtige Person dafür zu finden. Auf der anderen Seite stehen Postdocs und Promovierende mit befristeten Verträgen. Sie hätten das Wissen und würden es gern außerhalb der Hochschule einsetzen, aber es gibt kaum einen geordneten Weg dorthin.
Hier setzt BrightSync an. Gegründet haben das Start-up Dr. Iris Mencke, Dr. Tim Schulte und Prof. Dr. Tobias Ritter. Es entstand aus MAX!mize, dem Inkubationsprogramm der Max-Planck-Gesellschaft und von Max Planck Innovation. Der Claim lautet „Synchronizing Academia with Industry and Society“. Gemeint ist eine Transferplattform mit drei Teilen: ein Talentpool aus Forschenden vom Doktoranden bis zur Institutsleitung, die projektweise in Unternehmen arbeiten; ein durchsuchbarer Katalog deutscher Forschungseinrichtungen, von Fraunhofer, Helmholtz, Leibniz und Max Planck bis zu Universitäten und Hochschulen für angewandte Wissenschaften; und eine Academy, die Forschende auf den Wechsel in andere Sektoren vorbereitet. Den Anfang macht Deutschland, später soll die Plattform EU-weit wachsen.
Die Plattform ist das zentrale Asset des Unternehmens. Deshalb suchte BrightSync keinen Dienstleister für ein einzelnes Projekt, sondern einen technischen Partner auf Dauer. Die Ausgangslage war typisch für ein gefördertes Start-up: ein fester Budgetrahmen, ein harter Meilenstein zum Ende der Förderphase und eine Jury, die über die nächste Finanzierung entscheidet. Innerhalb weniger Wochen musste also ein MVP produktiv laufen. Forschende registrieren sich darin, pflegen ihre Forschungsgebiete anhand internationaler Taxonomien und bilden so die Datenbasis für ein späteres Matching mit Unternehmen. Danach folgten eine zweite Ausbaustufe mit Content-Management, Academy und Selbsteintrag der Institute, der dauerhafte Betrieb und eine Schnittstelle, über die Forschungseinrichtungen ihre Daten maschinell anbinden.